[PonsWarp 개념 교실 24] 토큰버킷 — API 요청을 어떻게 일정하게 제한하나
쉽게 말하면, 토큰버킷은 요청이 들어올 때마다 토큰을 하나씩 꺼내고, 토큰이 없으면 잠시 기다리거나 거부하는 요청 제한 장치다.
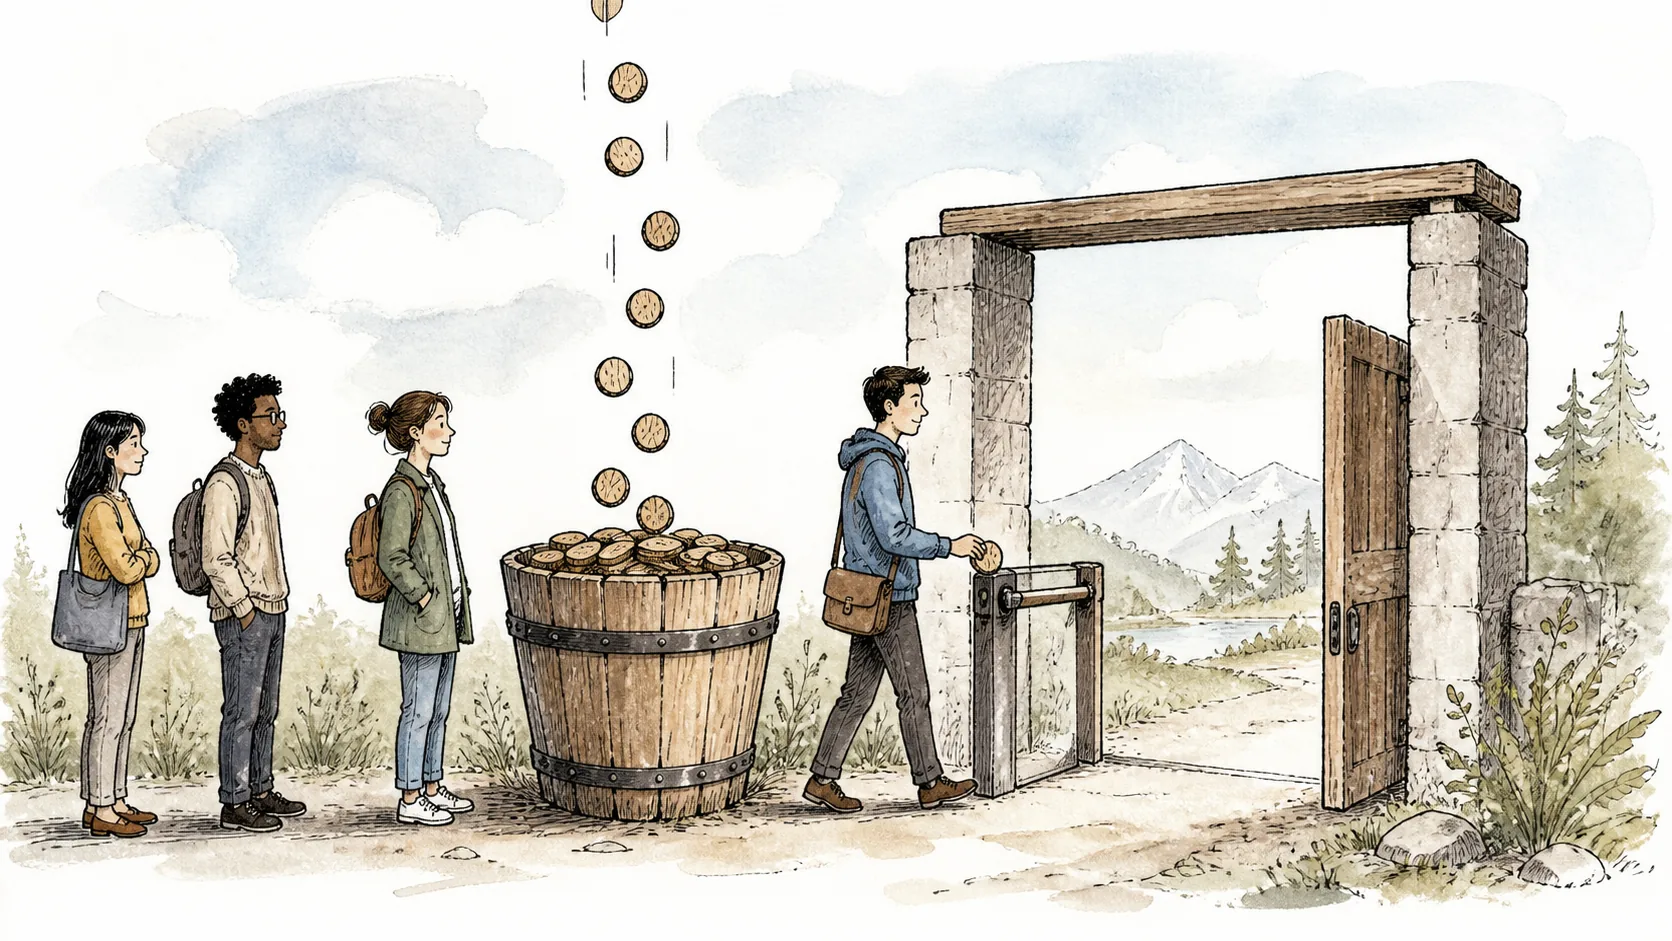
무조건 초당 N개만 허용하는 고정 창보다 순간 burst를 허용하면서도 장기적인 요청량은 제한할 수 있다.
동작
시간 → 토큰이 조금씩 충전
요청 → 토큰 1개 소비 → 통과
토큰 0개 → 429 또는 retry-after
PonsWarp Mesh API는 버킷 capacity 120, refill 2/s를 기본으로 둔다. 순간적으로 120개까지 처리할 수 있지만, 비워진 버킷은 초당 2개 속도로 회복된다.
왜 고정 윈도우보다 나은가
고정 윈도우는 경계 직전에 요청을 몰아 보내면 짧은 시간에 두 배 burst가 가능하다. 토큰버킷은 남은 토큰을 명시적으로 관리해 burst 양과 장기 속도를 함께 제어한다.
PonsWarp는 subject를 route+workspace+actor로 구성하고, 익명 요청은 IP를 해시해 사용한다. 따라서 한 사용자의 폭주가 다른 workspace까지 막지 않는다.
저장소 전략
InMemory 버킷은 빠르지만 단일 프로세스에서만 유효하다. Postgres 버킷은 여러 서버 인스턴스가 같은 제한을 공유할 수 있지만 DB 비용과 지연이 생긴다. PonsWarp는 RateLimiter 트레이트로 두 구현을 교체한다.
PonsWarp 적용 지점
| 항목 | 값 | 증거 |
|---|---|---|
| capacity | 120 | mesh_abuse.rs:17-26 |
| refill | 초당 2 | config.rs:326-370 |
| 저장 전략 | InMemory/Postgres | mesh_abuse.rs:28-237 |
| subject | route+workspace+actor/IP hash | mesh.rs:1931-2009 |
| 초과 응답 | 429 + retryAfterSeconds | mesh.rs:1931-2009 |
토큰버킷 수식과 시간
토큰버킷은 일정한 시간 간격으로 요청을 세는 장치가 아니다. 시간에 따라 토큰이 누적되지만 capacity를 넘지 않고, 요청이 올 때 필요한 토큰을 원자적으로 차감한다. PonsWarp Mesh API의 기본값은 capacity 120, refill 2 tokens/s다. 마지막 계산 시각이 t0, 현재가 t1이면 추가 토큰은 min(capacity, tokens + (t1-t0)*rate)로 계산한다.
texttokens(t1) = min(C, tokens(t0) + (t1-t0) × r)
request cost k
  ├─ tokens >= k : 차감 후 통과
  └─ tokens <  k : retry-after 계산 또는 429
입력은 현재 시각과 요청 cost, 상태는 (tokens, lastRefillAt), 출력은 허용·거부와 retry 정보다. 잔여 토큰을 DB에 저장한다면 두 요청이 동시에 읽고 쓰는 경쟁을 막아야 한다. 프로세스 메모리 버킷은 단일 인스턴스에는 간단하지만 수평 확장 시 인스턴스마다 별도 한도가 생긴다.
그냥 초당 N개로 자르면 안 되나?
고정 창은 경계가 바뀌는 순간 burst가 두 배처럼 보이는 경계 효과가 있고, 정상적인 짧은 burst도 모두 거부한다. 토큰버킷은 capacity만큼 순간적인 요청을 허용하면서 장기 평균을 refill rate로 제한한다. 대신 burst를 전부 허용하는 만큼 downstream이 감당할 수 있는 capacity를 잘못 정하면 짧은 시간에 부하가 몰린다.
429는 단순 오류 문자열보다 retry-after와 함께 반환해야 클라이언트가 재시도 폭주를 만들지 않는다. 비용이 다른 API가 있다면 요청마다 token cost를 다르게 둘 수 있지만, cost 단위를 문서화하지 않으면 호출자가 제한을 예측할 수 없다.
| 파라미터 | 의미 | 기본값 |
|---|---|---|
| capacity | 최대 burst | 120 |
| refill rate | 초당 회복량 | 2/s |
| cost | 요청별 소비량 | endpoint 정책 |
| retry-after | 다음 허용까지 예상 시간 | 계산값 |
분산 환경에서는 Redis 같은 원자 연산 저장소나 인스턴스 고정이 필요하다. 시계가 뒤로 가는 경우 토큰을 증가시키지 않고, 저장소 장애 때 fail-open인지 fail-closed인지도 보안·가용성 기준으로 정해야 한다.
분산 버킷의 원자성
두 인스턴스가 동시에 마지막 토큰을 읽으면 둘 다 통과시키는 경쟁이 생긴다. refill 계산과 차감은 하나의 원자 연산이어야 하며, TTL을 둬 사용하지 않는 bucket state가 저장소에 영원히 남지 않게 한다. 네트워크 지연으로 응답이 늦어도 서버의 허용 판정 시각은 저장소 연산 시점으로 일관되게 유지한다.
rate limit은 사용자 보호만이 아니라 downstream 비용을 제어하는 계약이다. 따라서 429 비율, 잔여 토큰, retry-after를 안전한 범위에서 관찰할 수 있어야 하며, credential·결제 API처럼 민감한 endpoint는 별도 bucket을 사용하는 편이 낫다.
구현 시 시간과 비용을 고정한다
토큰 계산은 요청 처리 도중 여러 번 현재 시각을 읽지 않는다. 하나의 판정에서 now를 고정하고, 그 시각으로 refill·차감·retry-after를 계산해야 경계에서 값이 서로 달라지지 않는다. 요청 cost가 1보다 큰 endpoint는 capacity보다 cost가 큰 경우를 명시적으로 거부한다. 그렇지 않으면 영원히 통과하지 못하는 요청이 대기열을 점유한다.
메모리 버킷은 빠르지만 프로세스 재시작 때 상태가 사라져 burst가 다시 열린다. 저장소 기반 버킷은 일관성을 얻는 대신 저장소 장애와 latency를 처리해야 한다. 선택은 “가장 강한 제한”이 아니라 API의 비용과 배포 토폴로지에 맞춰야 한다.
관찰 가능한 제한
운영자는 bucket key, 현재 토큰, refill rate를 그대로 노출하지 않고 endpoint별 허용·거부 수와 retry-after 분포를 본다. 특정 사용자만 계속 429를 받는다면 capacity가 작은지, client가 재시도 폭주를 만드는지 구분해야 한다. 제한을 바꿀 때도 기존 요청의 bucket 상태를 어떻게 마이그레이션할지 정한다.
결국 토큰버킷은 숫자 하나가 아니라 시간·경쟁·응답 계약을 함께 갖는 작은 상태 머신이다. 이 세 가지를 구현과 운영에서 같이 다뤄야 “초당 2개”라는 설정이 실제 보호 효과로 이어진다.
버킷을 적용할 때는 인증된 사용자·IP·API key 중 어떤 식별자를 기준으로 할지도 명시한다. 식별자 선택이 흔들리면 한 사용자가 여러 bucket을 우회하거나, 공유 NAT 뒤의 사용자가 서로의 요청을 막게 된다. 이 정책은 알고리즘보다 제품 경계에 가깝지만 실제 제한의 공정성을 결정한다.
한 문장 정리
토큰버킷은 순간 burst는 허용하면서 refill 속도로 장기 요청량을 제한하고, PonsWarp는 이를 Mesh API의 workspace·actor별 남용 방어에 적용한다.