[Backpressure 딥다이브] bufferedAmount와 backpressure가 파일 전송을 지킨다
파일 전송을 만들 때 처음 떠오르는 질문은 속도다. 얼마나 빨리 보낼 수 있는지, chunk를 얼마나 크게 잡아야 하는지, send를 얼마나 자주 호출할 수 있는지부터 궁금해진다. 그런데 브라우저 DataChannel로 큰 파일을 보내려면 속도보다 먼저 봐야 할 값이 있다. 상대와 내 런타임이 지금 이 속도를 받을 수 있는가. 로그를 다시 펼쳤을 때 눈에 들어온 건 예쁜 성공 화면이 아니라, Backpressure 주변에서 반복되던 작은 끊김이었다.
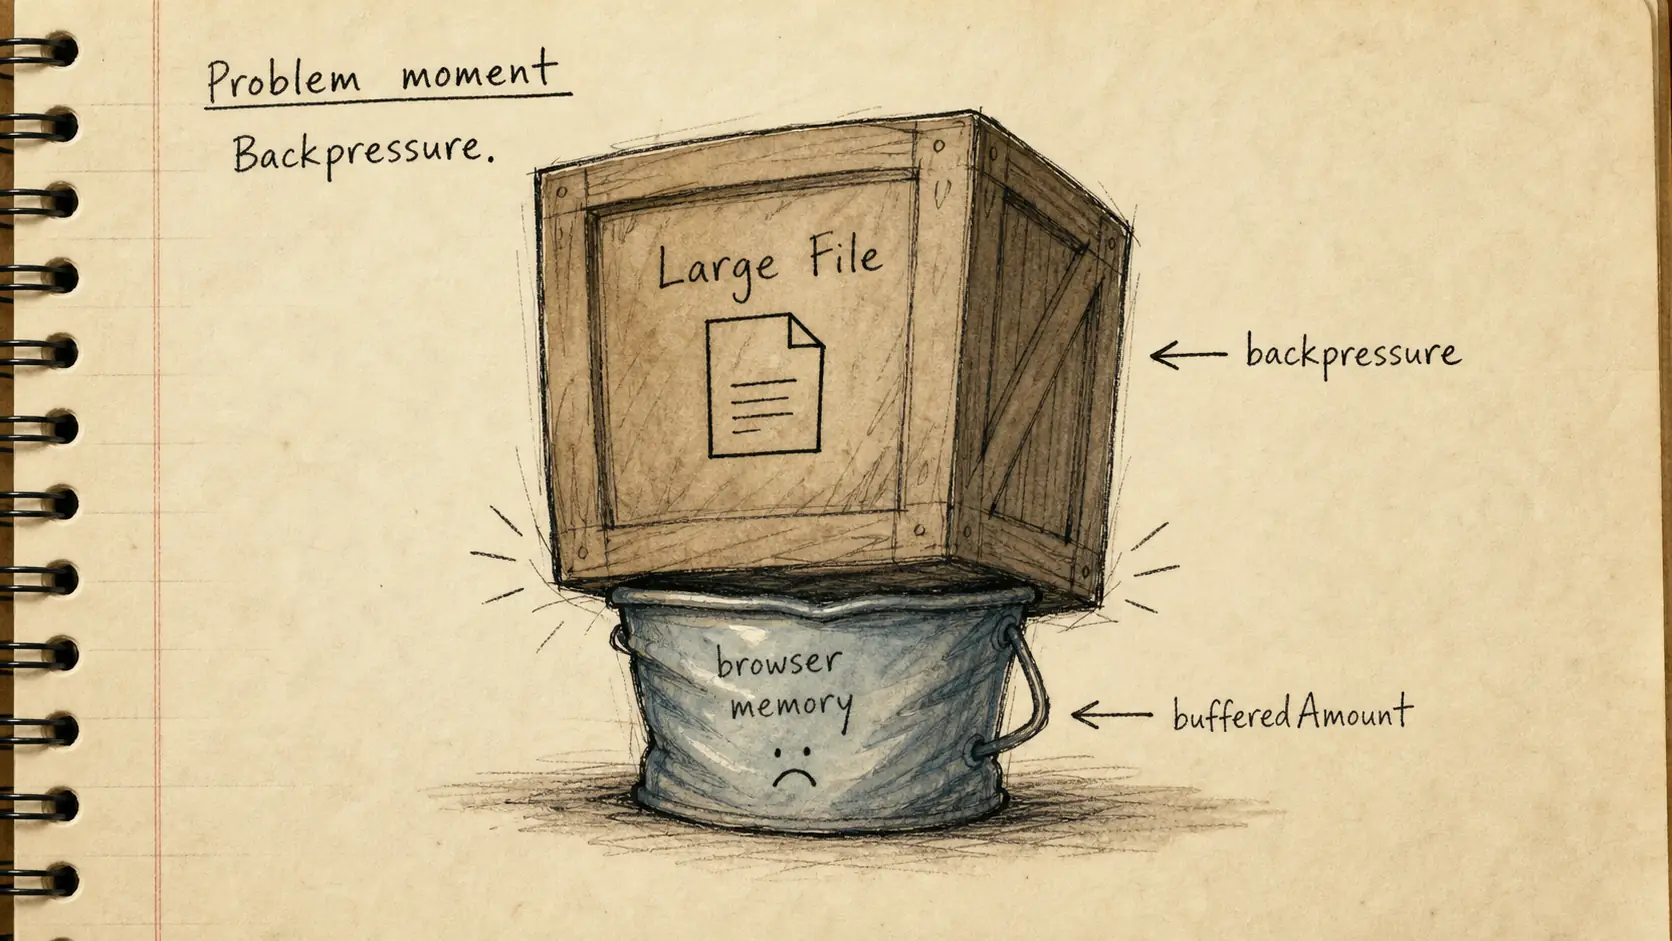
bufferedAmount를 모르고 전송이 터진 이유
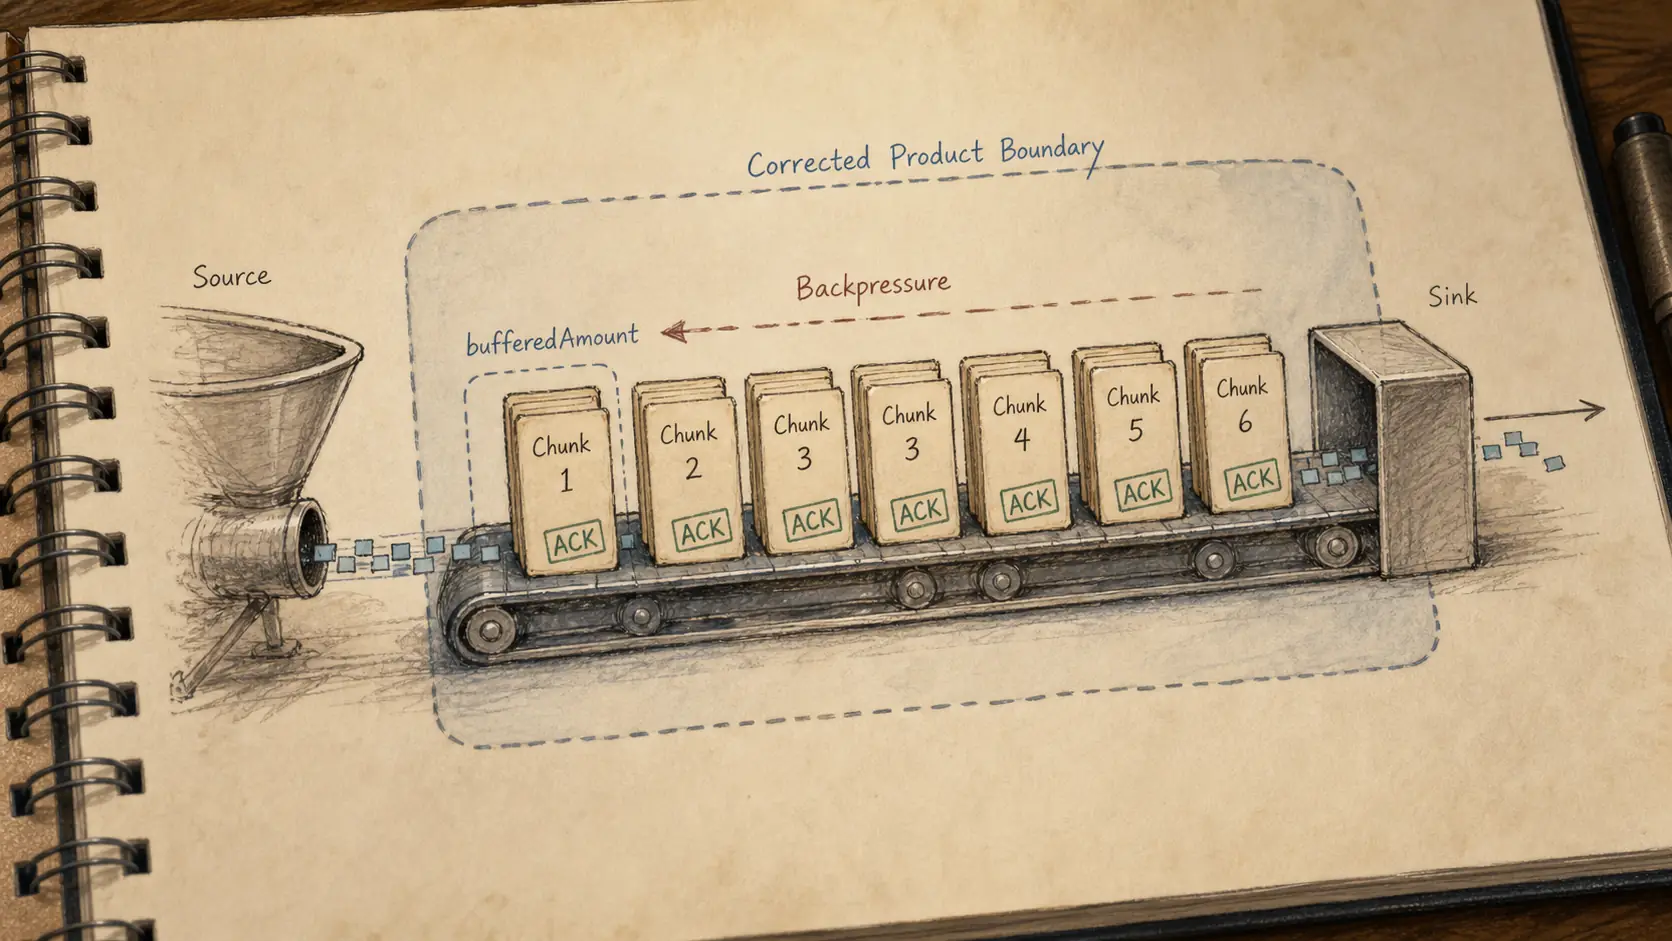
나는 처음에 backpressure를 속도를 낮추는 장치로만 생각했다. 지금은 조금 다르게 본다. 전송을 오래 버티게 만드는 안전장치다. 순간 최고 속도를 조금 포기하더라도 버퍼, 메모리, 수신 저장, 재시도 상태를 관리해서 완료율을 지키는 쪽에 가깝다. 파일 전송의 backpressure는 송신 버퍼와 수신 저장을 함께 봐야 한다. 수신자가 chunk를 처리한 뒤 ACK를 보내거나, 저장 큐 수위를 알려 주거나, 일정 크기 이상 밀리면 pause를 요청하는 식의 흐름이 필요하다.
구현은 제품마다 다르지만 원리는 같다. 보냈다가 아니라 상대가 처리할 수 있다에 맞춰 속도를 조절한다. PonsLink의 세션과 권한 흐름도 완전히 별개는 아니다. 실제 payload는 피어 사이로 흐르더라도, 사용자가 보는 상태와 복구 경로는 제품이 책임져야 한다. 직접 연결이 느리면 relay나 cloud drop 같은 대체 경로를 안내할 수 있어야 하고, 전송이 쉬는 이유를 화면에서 설명해야 한다.
내부 구조를 숨길 수는 있지만, 기다림과 제한까지 숨기면 사용자는 제품을 믿기 어렵다. 수신 writer queue를 무시하는 실패도 많다. 네트워크는 빠르게 받았지만 저장소가 느려서 메모리 큐가 커진다. 브라우저 탭이 오래 열려 있거나 기기 저장소가 바쁘면 이 차이가 더 커진다. 이때 송신 쪽 bufferedAmount만 낮다고 안심하면 안 된다. 수신자가 처리 완료를 알려 주는 신호가 필요하다.
섞기 쉬운 인접 개념
파일 전송 UI에서 진행률은 생각보다 위험한 값이다. 송신자가 읽은 byte, send에 넘긴 byte, 네트워크로 빠져나간 byte, 수신자가 받은 byte, 저장까지 끝난 byte, checksum이 맞은 byte가 모두 다르다. 사용자는 하나의 막대를 보지만 제품은 어떤 기준인지 알아야 한다. 이 값을 보지 않고 큰 파일을 빠르게 밀어 넣으면 메모리가 커지고, 브라우저가 버거워지고, 연결이 불안정해질 수 있다.
특히 파일 chunk가 192KB처럼 어느 정도 큰 단위라면 몇십 개만 밀려도 수 MB가 금방 쌓인다. 좋은 네트워크에서는 티가 덜 나지만 모바일 핫스팟, 회사망, 느린 수신 저장소가 끼면 문제가 빨리 드러난다. PonsWarp 같은 대용량 파일 전송에서 backpressure를 핵심으로 봐야 하는 이유가 여기에 있다. 빠른 send loop는 데모에서 멋있다. 하지만 실제 사용자는 큰 파일, 느린 저장소, 흔들리는 네트워크, 오래 켜 둔 브라우저 탭을 가져온다.
이 환경에서는 버퍼 수위를 지키는 정책이 속도보다 먼저다. 그다음 화면 문구를 붙인다. 버퍼가 높아서 쉬는 상태, 수신자가 저장 중인 상태, 재시도 중인 상태, 사용자가 pause한 상태는 모두 다르다. 내부적으로는 비슷하게 멈춘 것처럼 보여도 사용자가 취할 행동이 다르다. 기다리면 되는지, 다시 시도해야 하는지, 다른 경로로 전환해야 하는지 알려 줘야 한다.
Pause와 resume도 제품 상태로 봐야 한다. 내부 루프가 쉬는 동안 사용자는 전송이 멈춘 것처럼 느낄 수 있다. 그래서 상대 기기가 받는 속도에 맞추는 중, 전송 속도를 조절하는 중 같은 문구가 필요하다. 이 문구가 없으면 backpressure는 정상 동작인데도 사용자는 장애로 받아들일 수 있다.
backpressure가 지키는 것
송신 버퍼, 수신 저장, ACK, pause/resume을 한 흐름 제어로 묶었다. 운영 지표도 같은 이유로 나눠 본다. 최고 속도, 평균 속도, 완료율, 재시도 후 완료율, 중간 취소율, high-water 체류 시간은 서로 다른 이야기를 한다. 최고 속도만 개선됐는데 완료율이 떨어졌다면 제품은 나빠진 것이다. 반대로 속도는 조금 낮아졌지만 장시간 완료율이 올라갔다면 backpressure가 제 역할을 했다고 볼 수 있다.
가장 낙관적인 기준은 송신자가 send에 넘긴 byte다. 빠르게 올라가지만 실제 완료와 차이가 커질 수 있다. 더 보수적인 기준은 수신 ACK나 저장 완료 기준이다. 느리게 보일 수 있지만 완료에 가깝다. 대용량 파일에서는 이 차이가 사용자 신뢰를 만든다. 99%에서 오래 멈추는 전송은 대부분 기준을 잘못 잡았거나 마지막 검증을 화면에 설명하지 못한 경우다.
장시간 전송에서는 pause/resume 정책이 중요하다. 사용자가 탭을 백그라운드로 보내거나 네트워크가 잠깐 끊기거나 수신 저장이 늦어질 수 있다. 이때 무작정 실패 처리할지, 잠시 멈췄다가 이어갈지, cloud 경로로 전환할지 제품 기준이 있어야 한다. backpressure는 단순히 루프 안의 조건문이 아니라 이런 전환을 가능하게 만드는 상태 모델이다. 대용량 전송에서는 최고 속도보다 오래 유지되는 속도가 중요하다.
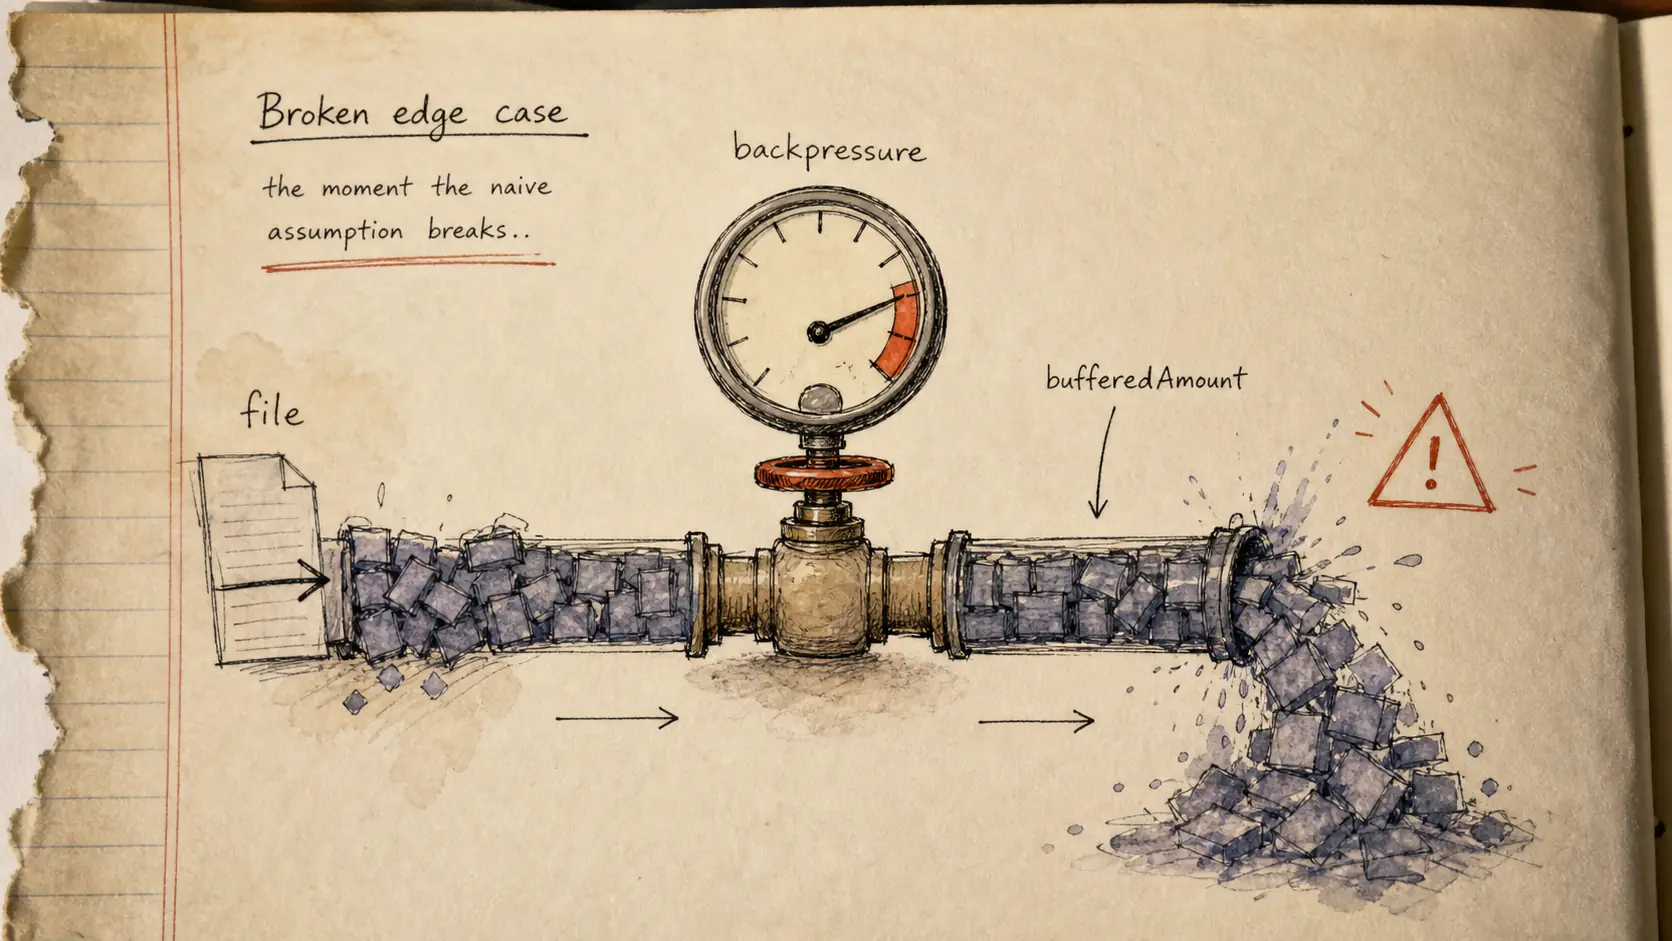
5초 동안 빠른 것보다 30분 동안 끊기지 않는 쪽이 제품에는 더 낫다. 그래서 평균 Mbps만 보지 말고 bufferedAmount의 최대값, high-water 도달 횟수, drain까지 걸린 시간, ACK 지연, 재시도 횟수, 완료율을 같이 봐야 한다. Backpressure가 없을 때 흔한 실패는 보냈다고 믿었지만 쌓였을 뿐인 상황이다. 송신자는 send 호출을 끝냈고 progress도 올라갔다. 하지만 bufferedAmount는 높게 유지되고, 수신 저장은 따라오지 못하고, 연결이 흔들리면 대량 재시도나 실패 로그가 send 호출 수만 남기면 이 문제를 찾기 어렵다.
Backpressure를 설명할 때 서버/클라이언트/사용자 중 누구 문장으로 말하는지 먼저 고르면 논쟁이 줄었다.
API 관점에서 본 bufferedAmount
bufferedAmount는 송신 쪽의 중요한 신호지만 전부는 아니다. 수신 쪽도 데이터를 받아서 메모리에 두고, Blob이나 File System Access API, IndexedDB, stream writer 같은 저장 경로로 넘겨야 한다. 네트워크 수신은 빠른데 저장이 느리면 뒤에서 줄이 생긴다. 이 줄을 무시하면 송신자는 계속 성공했다고 믿고 수신자는 점점 부담을 떠안는다. 브라우저 탭의 생명주기도 같이 봐야 한다. 사용자가 전송 중에 화면을 잠그거나 탭을 뒤로 보내면 timer와 IO의 움직임이 달라질 수 있다.
노트북은 전원 상태에 따라 성능이 바뀌고, 모바일 브라우저는 백그라운드에서 더 공격적으로 멈출 수 있다. 이런 환경에서는 send loop가 빠른지보다 멈췄다가 돌아올 때 상태를 잃지 않는지가 더 중요하다. Chunk size도 같은 방식으로 본다. 너무 작으면 overhead가 늘고, 너무 크면 버퍼가 급하게 불어난다. 192KB 같은 값은 근거 없이 신성한 숫자가 아니다. 브라우저와 네트워크와 저장 경로를 놓고 조정해야 하는 출발점이다.
값을 바꿨다면 버퍼 파형과 완료율이 어떻게 달라졌는지 기록한다. 로그도 같은 기준을 공유해야 한다. bufferedAmount, high-water 도달 시각, low-water 복귀 시각, receiver ACK 지연, writer queue 길이, checksum 결과를 남긴다. 숫자가 많아 보이지만 장애 때는 이 값들이 시간을 아껴 준다. 반대로 성공 여부만 남기면 다음 실패에서 또 감으로 추측해야 한다.
브라우저가 주는 제약
또 하나는 취소와 재개를 전송 루프 바깥 기능으로 밀어두지 않는 것이다. 큰 파일을 보내는 동안 사용자는 언제든 멈추고 싶어 한다. backpressure 때문에 쉬는 상태와 사용자가 의도적으로 pause한 상태는 다르다. 재개할 때도 마지막으로 저장 확인된 offset에서 이어갈지, 송신 버퍼에 들어간 만큼을 믿을지 결정해야 한다. 이 기준이 없으면 진행률은 올라갔는데 실제 파일은 덜 저장된 애매한 상태가 생긴다.
진행률 표시도 여기서 조심해야 한다. 송신자가 send를 호출한 byte만 기준으로 progress를 올리면 사용자는 거의 끝난 줄 알 수 있다. 실제로는 브라우저 버퍼나 수신 저장소에 아직 남아 있을 수 있다. 더 안전한 진행률은 수신 확인, 저장 완료, checksum 확인 중 어디까지 끝났는지에 따라 단계가 나뉜다. 화면에는 단순한 막대 하나만 보여도 내부 기준은 분명해야 한다.
Backpressure를 코드로 옮길 때 가장 먼저 필요한 것은 임계값이다. high-water는 더 보내면 위험하다고 보는 수위이고, low-water는 다시 보내도 괜찮다고 보는 수위다. 예를 들어 bufferedAmount가 몇 MB를 넘으면 send loop를 멈추고, bufferedamountlow 이벤트나 주기적 확인으로 값이 내려왔을 때 다시 보낸다. 숫자는 브라우저, chunk 크기, 대상 파일 크기, 기기 성능에 따라 조정해야 한다. 나는 전송 상태를 몇 단계로 나누는 편이 낫다고 본다.
읽는 중, 보내는 중, 상대가 저장하는 중, 무결성 확인 중, 완료처럼 내부 사건과 화면 문구를 맞춘다. 모든 단계를 늘 보여 줄 필요는 없지만, 문제가 생겼을 때 설명할 수 있어야 한다. backpressure는 이 단계 사이에서 속도를 조절하는 장치다. 그래서 파일 전송 루프에는 멈추는 조건이 필요하다. high-water를 넘으면 잠깐 쉬고, low-water 아래로 내려오면 다시 보낸다. 이 방식은 전송 속도를 일부러 망치는 것이 아니다.
상대가 받을 수 있는 속도에 맞춰 파형처럼 흐르게 만드는 것이다. 수도꼭지를 끝까지 열어 두는 대신 배수구가 감당할 만큼 조절하는 일에 가깝다. '[Backpressure 딥다이브 bufferedAmount와 backpressure가 파일 전송을 지킨다'을 관통하는 질문은 이 섹션에서도 같았고, 답만 더 구체적이 됐다.
설계할 때 던져야 할 질문
결국 backpressure를 넣는다는 말은 전송을 겁내자는 뜻이 아니다. 제품이 감당할 수 있는 속도를 계속 확인하자는 뜻이다. 관련해서는 [과 [을 같이 읽으면 좋다. bufferedAmount와 backpressure는 성능 튜닝 팁이 아니라, 브라우저가 감당할 수 있는 속도와 사용자가 이해할 수 있는 상태를 맞추는 제품 설계에 가깝다. DataChannel의 send()를 호출하면 애플리케이션 입장에서는 데이터를 넘긴 것처럼 느껴진다.
하지만 네트워크로 실제로 나갔는지, 상대가 받았는지, 수신자가 저장까지 끝냈는지는 다른 문제다. bufferedAmount는 이 차이를 보여 주는 값이다. 아직 전송 계층 밖으로 빠져나가지 못한 데이터가 얼마나 쌓였는지 알려 준다. bufferedAmount는 DataChannel이 아직 네트워크로 내보내지 못하고 내부에 쌓아 둔 byte 수를 알려 준다. 이 값이 계속 커지는데도 send loop를 밀어붙이면 겉으로는 보낸 것처럼 보이지만 실제로는 브라우저 안에 줄을 세우는 중이다.
수신 쪽 저장이 늦거나 디스크 writer가 막히면 병목은 더 뒤에서 생긴다. backpressure는 이 수위를 보고 보내는 속도를 조절하는 약속이다. 내가 다시 파일 전송을 구현한다면 먼저 네 가지를 적겠다. chunk size를 왜 그 값으로 잡았는가. bufferedAmount의 high-water와 low-water는 얼마인가. 수신 writer queue는 어떻게 알려 주는가. ACK와 retry는 어떤 단위로 움직이는가. 이 네 가지가 없으면 send loop는 빨라 보일 수 있어도 제품은 오래 버티기 어렵다.
중요한 것은 임계값을 감으로만 두지 않는 것이다. chunk size가 64KB인지 192KB인지에 따라 버퍼 증가 속도가 달라진다. 수신 저장 경로가 메모리인지 디스크 stream인지에 따라 처리 지연도 달라진다. 장시간 전송에서 안정적으로 유지되는 값을 찾아야 한다. 작은 파일 데모에서 잘 되는 수치가 20GB 전송에서도 괜찮다는 보장은 없다.
이어서 보면 좋은 글
이 노트까지 정리하면 DataChannel 파일 전송에서 순서, 신뢰성, 역압이 서 ordered는 메시지 순서를 다루고, reliable은 도착 가치를 다루며, backpressure는 지속 가능한 속도를 다룬다. 셋 중 하나만 맞아도 제품은 부족하다.에서 이어진다. 다음에는 이 기준을 PonsWarp와 PonsLink의 전송 설계에 다시 비춰 볼 차례다. realtime-network-22-bufferedamou 실험은 작게 시작해도 된다. 같은 파일을 좋은 네트워크와 제한된 네트워크에서 보내고, bufferedAmount가 어떤 모양으로 오르내리는지 기록한다.
high-water에 자주 걸리는데도 완료율이 안정적이면 정책이 일을 하고 있는 것이다. high-water를 거의 안 건드리는데 수신 저장이 늦다면 병목은 다른 곳에 있다. 이 구분을 하지 않으면 chunk 크기만 계속 바꾸는 엉뚱한 튜닝에 빠지기 쉽다. 실패 이름을 작게 붙이면 운영이 쉬워진다. send buffer high-water reached, receiver writer queue delayed, ack timeout, resume after drain, checksum retry처럼 나눠 둔다. 사용자가 보는 문구는 더 쉬워야 하지만, 내부 사건 이름은 정확해야 한다.
그래야 느려요라는 문의를 버퍼 적체, 수신 저장 지연, 네트워크 손실, 재시도 중 어디에 붙일지 알 수 있다. 나는 처음에 backpressure를 속도를 낮추는 장치로만 생각했다. 지금은 조금 다르게 본다. 전송을 오래 버티게 만드는 안전장치다. 순간 최고 속도를 조금 포기하더라도 버퍼, 메모리, 수신 저장, 재시도 상태를 관리해서 완료율을 지키는 쪽에 가깝다.
마치며
이 글에서 확인한 경계는 다음 변경의 기준으로 남겼다.