[Mesh 딥다이브] 연결 수 공식으로 보는 Mesh의 비용
n(n-1)/2라는 공식은 칠판에서는 가볍다. n명이 들어오면 n개 노드 중 두 노드를 고르는 조합이 몇 개인지만 세면 된다. 그런데 브라우저 네 개를 실제 방에 붙여 보면 숫자의 표정이 달라진다. 선은 여섯 개뿐인데 offer, answer, candidate, 연결 상태, 재시도 로그가 한꺼번에 움직인다. 로그를 다시 펼쳤을 때 눈에 들어온 건 예쁜 성공 화면이 아니라, Mesh 주변에서 반복되던 작은 끊김이었다. 그래서 용어 사전 대신, 그 날 무엇을 보고 무엇을 바꿨는지부터 적는다. 같은 단어를 쓰더라도 제품 문맥이 다르면 답이 갈렸다. 그 갈림길을 숨기지 않는 쪽으로 썼다.
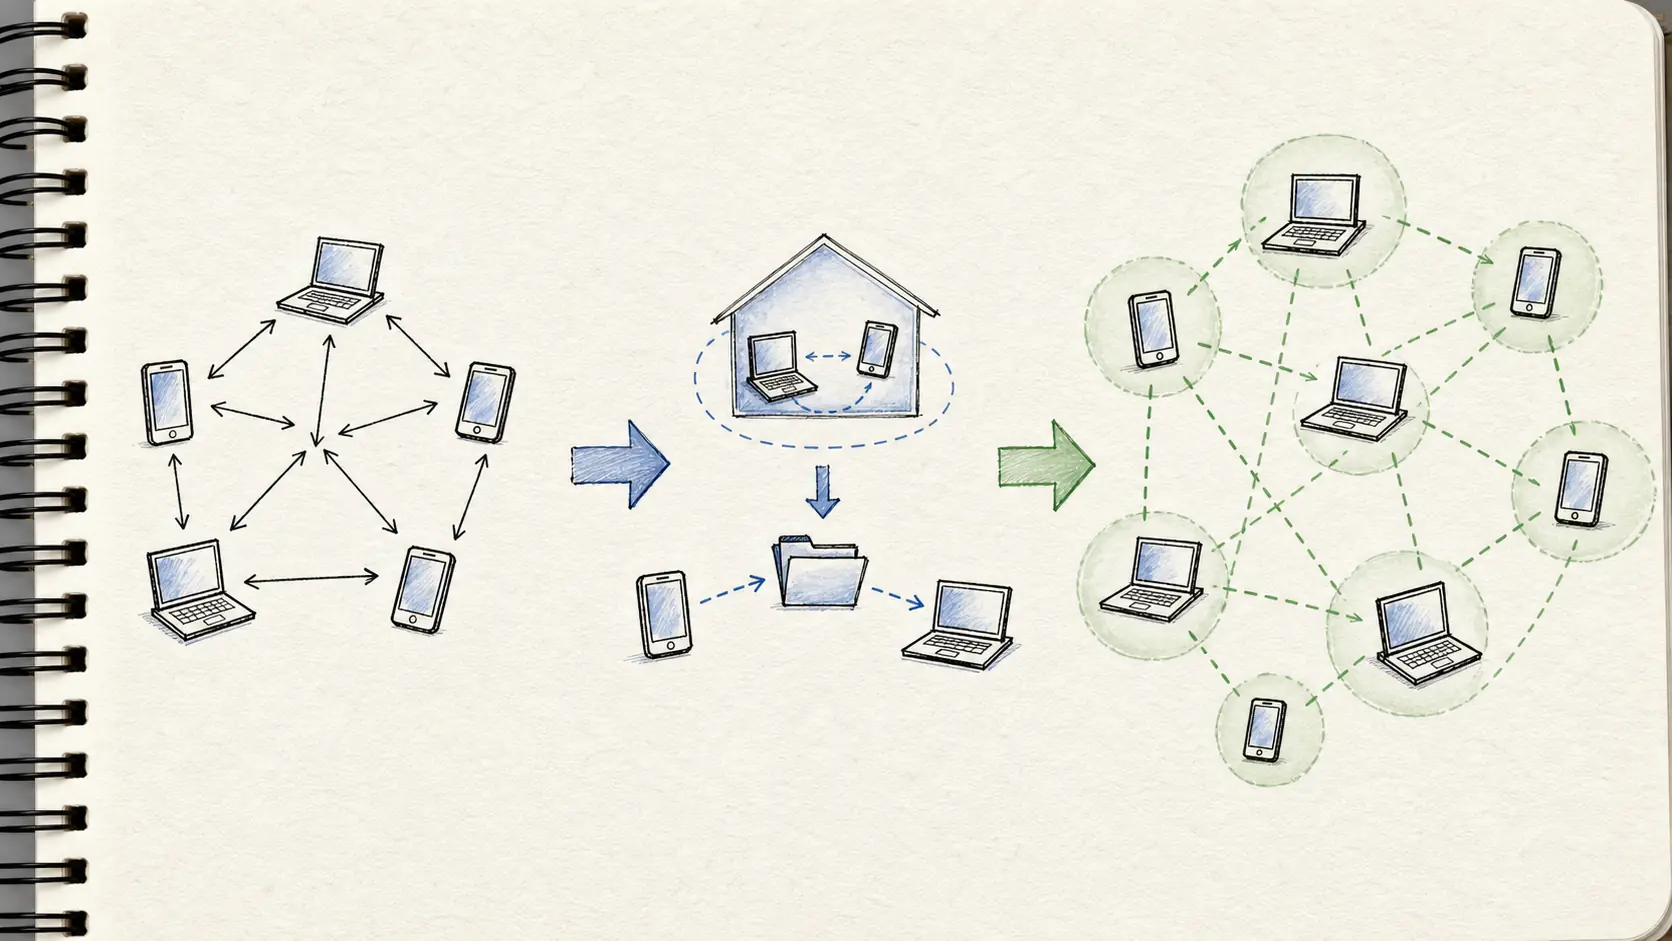
Mesh에서 먼저 깨진 것
Mesh 테스트를 한 번 성공으로 끝내면 가장 위험한 부분을 놓친다. 공식이 늘리는 것은 연결 수만이 아니라 테스트 조합이다. 3명 방에서는 한 명이 느릴 때, 한 연결만 실패할 때, 중간에 나갔다가 다시 들어올 때를 비교해야 한다. 8명 방에서는 이 조합이 훨씬 빠르게 커진다. 테스트를 설계할 때는 좋은 네트워크와 나쁜 네트워크를 같은 표에 두는 편이 좋다.
좋은 네트워크에서는 설계가 대부분 그럴듯해 보인다. 회사 방화벽, VPN, 모바일 데이터, 불안정한 와이파이, 오래 열린 탭, 절전 모드가 들어오면 다른 문제가 나온다. 후보 수집이 늦은 것인지, relay로 넘어간 것인지, 수신자가 처리하지 못한 것인지, 송신자가 업로드를 버티지 못한 것인지 이름을 나눠야 한다. Mesh 비용을 서버 비용이 낮다는 말로만 설명하면 놓치는 것이 많다.
서버가 미디어 payload를 직접 운반하지 않더라도 signaling은 남는다. 누가 방에 들어왔는지, 어떤 권한을 가졌는지, 어떤 candidate를 누구에게 전달해야 하는지, 연결이 실패했을 때 누가 다시 시도해야 하는지를 조율해야 한다. 특히 Mesh에서는 재현 조건을 같이 적어야 의미가 있었다. 그래서 로그도 연결 단위와 방 단위를 나눠야 한다. room_joined만으로는 부족하다. peer connection 생성 시각, 첫 candidate 도착 시각, selected candidate, ICE 상태 변화, retry count, bitrate, packet loss, bufferedAmount 같은 값을 최소한의 이름으로 남겨야 한다.
모든 값을 화면에 보여 줄 필요는 없지만, 화면 문구와 로그는 같은 상태 전이를 보고 있어야 한다.
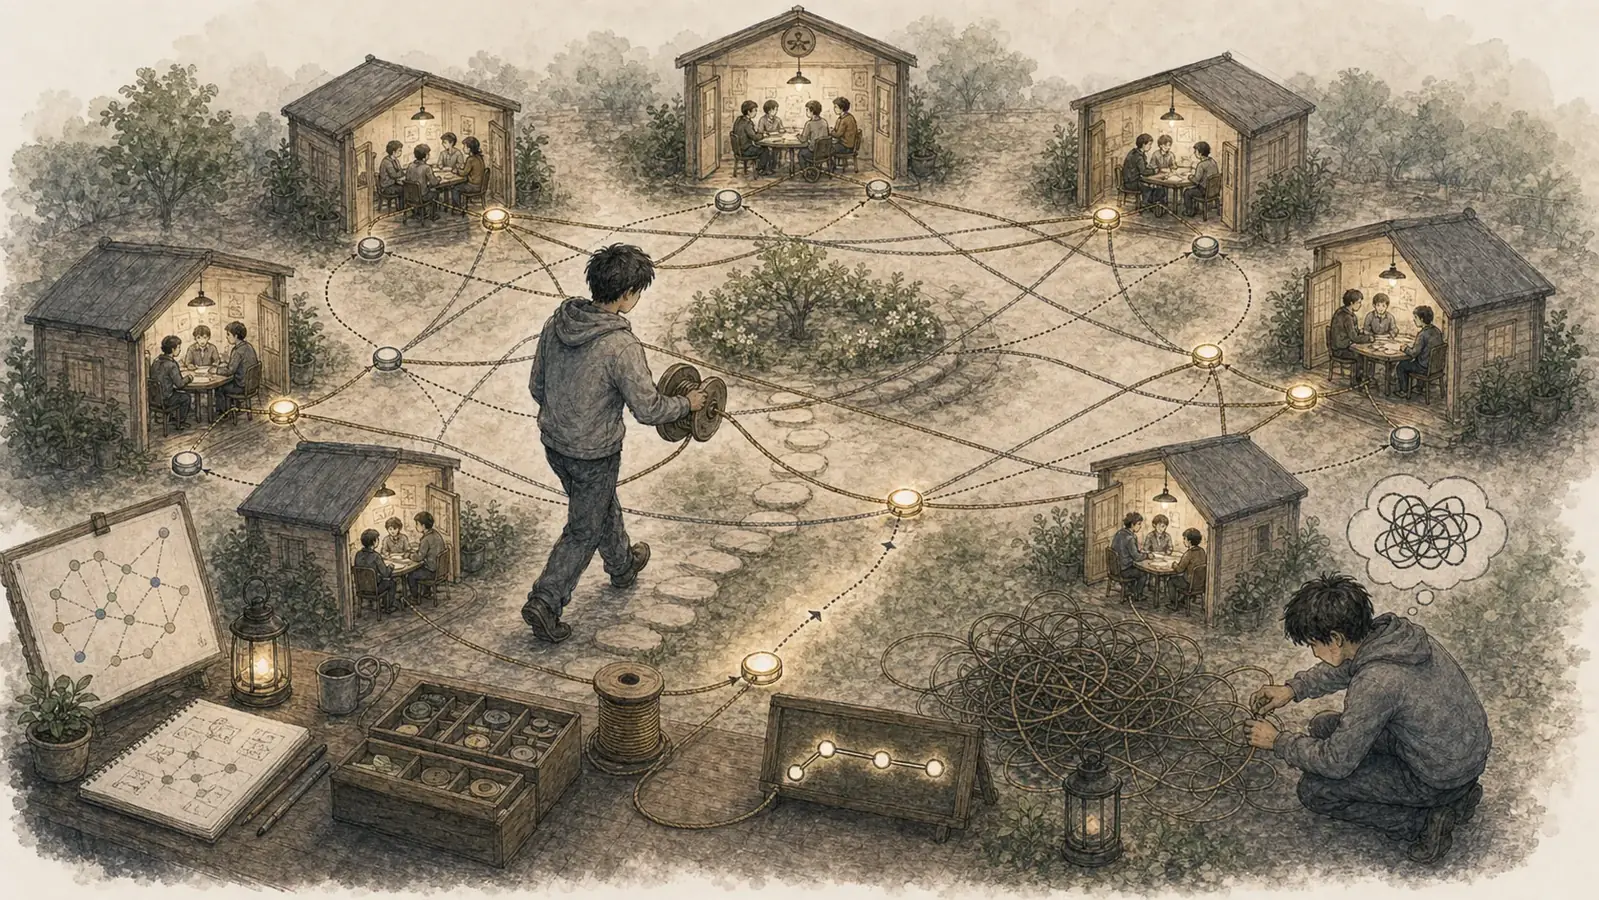
처음에 세웠던 가정
또 하나 조심할 점은 연결 수와 품질을 바로 연결하지 않는 것이다. 연결 수가 적어도 특정 피어의 업로드가 약하면 품질은 흔들릴 수 있다. 연결 수가 많아도 짧은 데이터 전송이라면 버틸 수 있는 경우가 있다. Mesh 비용 계산은 평균적인 성공 여부보다 p95 연결 시간, relay 비율, 재시도 후 성공률, 중단 후 복구 가능성처럼 꼬리 구간을 함께 봐야 한다.
그래서 공식 옆에는 항상 사용자의 장면을 같이 적어야 한다. 누가 기다리는가. 상대가 나갔을 때 방은 남아 있는가. 서버는 payload를 운반하는가, 아니면 약속만 전달하는가. 직접 경로가 실패하면 사용자는 무엇을 볼 수 있는가. 이 질문을 붙여야 n(n-1)/2가 외운 정의가 아니라 운영 비용을 계산하는 출발점이 된다. | 인원 n | peer connection 수 | 방향성 있는 송수신 부담을 볼 때 | 운영에서 먼저 볼 것 | |---:|---:|---:|---| | 3명 | 3개 | 각 피어가 2명과 주고받음 | 부분 연결 실패를 화면에 나눠 보일 수 있는가 | | 5명 | 10개 | 각 피어가 4명과 주고받음 | 업로드와 CPU가 특정 기기에서 먼저 막히는가 | | 8명 | 28개 | 각 피어가 7명과 주고받음 | signaling 이벤트와 ICE 상태를 추적할 수 있는가 | | 12명 | 66개 | 각 피어가 11명과 주고받음 | 제품 정책으로 제한하거나 다른 경로로 넘길 기준이 있는가 |
운영에서 더 까다로운 부분은 방 상태와 연결별 상태가 서로 다르다는 점이다. 방은 아직 살아 있지만 특정 두 피어만 실패할 수 있다. 한 참여자의 카메라는 보이지만 화면 공유는 늦을 수 있다. 파일 전송은 연결됐지만 수신자가 저장을 따라가지 못할 수 있다. 이 차이를 한 문장 오류로 덮으면 사용자는 계속 다시 누르고, 운영자는 재현되지 않는 문의를 받는다. 이 체크리스트는 Mesh를 쓰지 말자는 결론이 아니다. 작은 방, 짧은 세션, 제한된 품질 목표, 명확한 실패 문구가 있으면 Mesh는 여전히 단순하고 빠르게 시작할 수 있다. 다만 시작이 쉽다는 사실과 운영이 가볍다는 말은 다르다. 공식은 그 차이를 숫자로 보이게 해 준다. 특히 Mesh에서는 재현 조건을 같이 적어야 의미가 있었다.
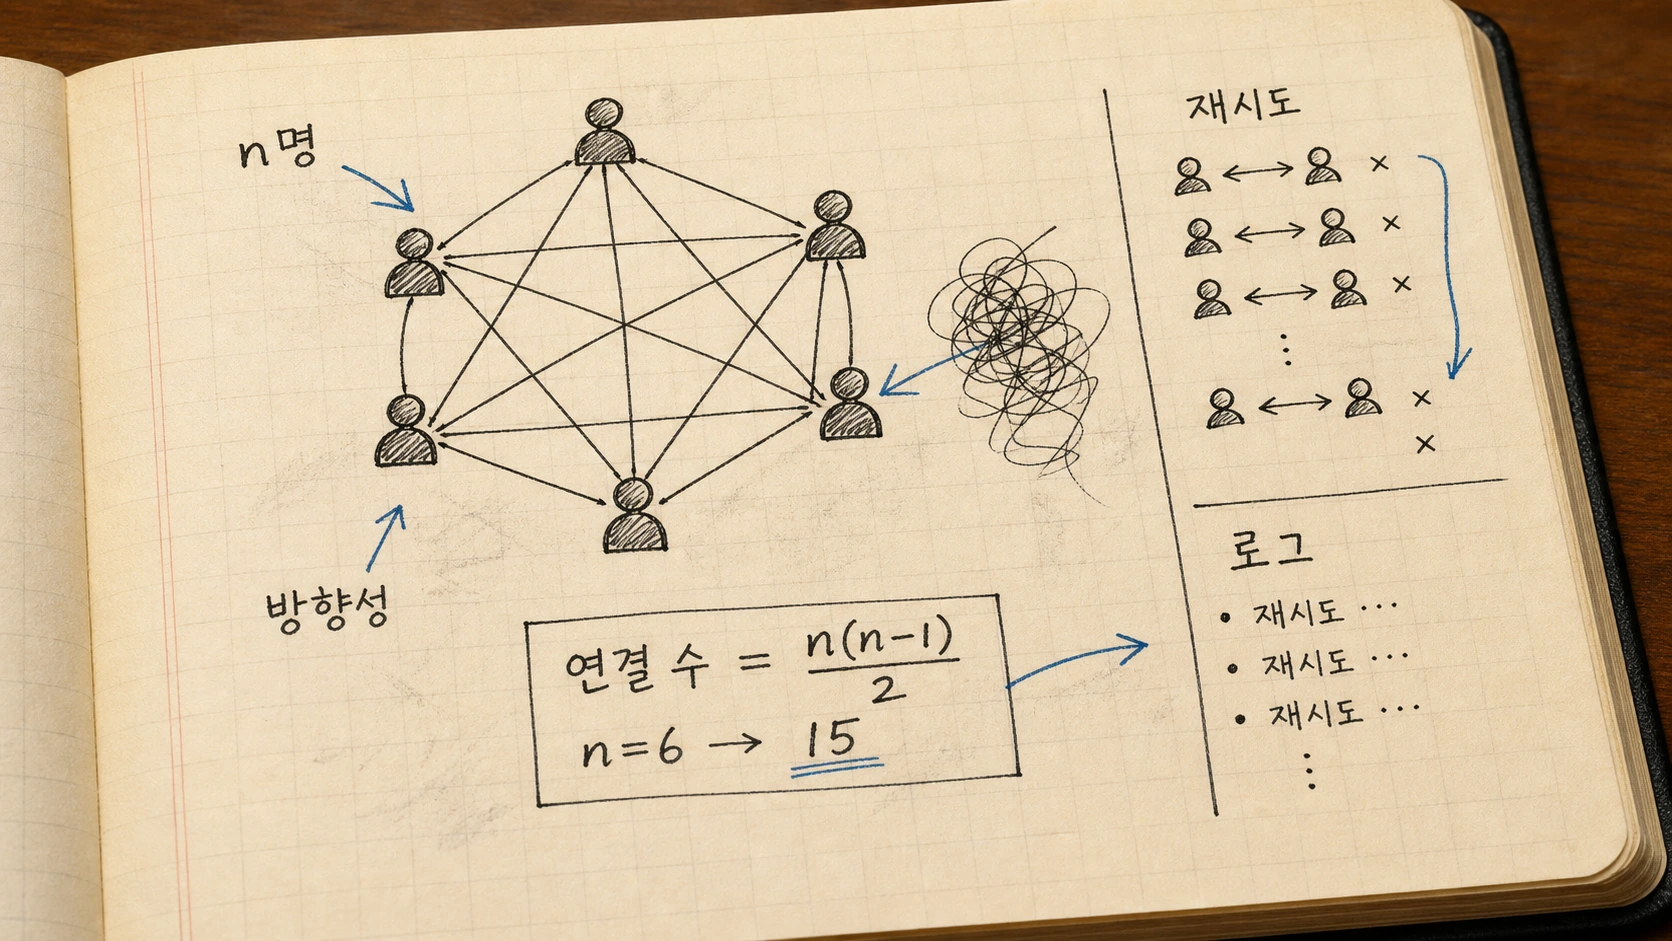
가정을 깨는 반례
공식이 실제 제품 판단에 쓰이는 자리는 대체로 세 군데다. 첫째, 방 최대 인원을 어디에 둘지 정한다. 둘째, 영상 품질이나 파일 chunk 크기의 기본값을 정한다. 셋째, Mesh로 계속 버틸지, relay나 SFU 전환 기준을 둘지 판단한다. 이 기준은 기술 취향이 아니라 사용자가 기다릴 수 있는 시간과 운영자가 설명할 수 있는 실패 범위에서 나온다. 공식으로 세는 조합이 실제 연결 절차와 운영 사건으로 번지는 흐름이다. 특히 Mesh에서는 재현 조건을 같이 적어야 의미가 있었다.
연결 전체 실패, 부분 실패, 느린 전송, 관측 누락을 같은 오류로 묶지 않기 위한 실패 지도다. 특히 Mesh에서는 재현 조건을 같이 적어야 의미가 있었다. Mesh에서 모든 참여자가 서로 직접 연결되면 연결 수는 n(n-1)/2로 늘어난다. 여기서 n은 방 안의 노드 수이고, 공식은 n개 노드 중 두 노드를 고르는 조합을 뜻한다. 2명은 1개, 3명은 3개, 4명은 6개다. 숫자만 놓고 보면 단순하지만, 제품에서는 각 조합마다 일이 붙는다.
이 차이를 기록하지 않으면 장애 회고가 늘 같은 문장으로 끝난다. 특정 사용자만 안 보였다는 말, 잠깐 끊겼다는 말, 다시 들어오니 됐다는 말은 모두 비슷하게 들린다. 하지만 원인은 candidate 수집 지연, TURN relay 전환, 브라우저 절전, 송신자의 업로드 한계, 수신자의 처리 지연으로 갈라진다. 공식이 늘린 연결 수만큼 원인을 붙일 자리가 생긴다. 상태 전이는 특히 비용을 숨기기 쉽다.
new, checking, connected, disconnected, failed, closed 같은 이름은 개발자에게 익숙하지만, 여러 연결이 동시에 움직이면 방 하나의 상태로 접을 수 없다. 어떤 연결은 connected이고 다른 연결은 checking일 수 있다. 사용자가 보는 화면은 하나인데 내부에서는 서로 다른 시간이 흐른다. Mesh를 설명할 때 서버/클라이언트/사용자 중 누구 문장으로 말하는지 먼저 고르면 논쟁이 줄었다.
비용 공식으로 경계 다시 그리기
에서 이어진다.에서 더 넓은 구조로 넘어간다. 이 단계에서 비용은 이미 여러 곳으로 퍼져 있다. 서버는 payload를 들고 있지 않아도 메시지 순서와 권한을 책임진다. 브라우저는 화면만 그리지 않고 업로드, 디코딩, 버퍼, 재시도를 감당한다. QA는 한 번 연결되는지만 보지 않고, 어느 연결만 실패했을 때 나머지 방이 어떻게 보이는지 확인해야 한다. 특히 Mesh에서는 재현 조건을 같이 적어야 의미가 있었다. - [ 인원별 연결 수 표를 만든다.
- [ 연결별 상태와 방 상태를 분리한다.
- [ 부분 장애 문구를 준비한다.
- [ Mesh 최대 인원을 제품 정책으로 제한한다.
- [ p95 연결 시간, relay 비율, 재시도 후 성공률, 중단 후 복구 가능성을 기록한다. 테스트 조합도 같은 방식으로 본다. 4명 방에서 한 명이 나가고 다시 들어오는 경우, 한 명만 모바일 데이터인 경우, 한 연결만 relay로 바뀌는 경우, 화면 공유와 카메라가 동시에 켜진 경우는 서로 다른 실험이다. 모든 조합을 무한히 돌릴 수는 없지만, 제품이 허용하는 최대 인원 안에서는 대표 실패를 이름으로 남겨야 한다. 이름이 있어야 재현 조건, 로그 필드, 사용자 문구가 같은 방향을 본다.
구현과 운영에 남긴 조건
Mesh를 제품에 넣을 때 인원 제한은 숨길 부끄러운 조건이 아니다. 오히려 사용자와 운영자가 같은 기대를 갖게 하는 약속이다. 방이 보통 2명이어도 한 번 8명이 들어오면 peer connection은 28개가 된다. 12명은 66개다. 이 숫자를 감당할 수 있는지보다, 감당하지 않기로 한 순간을 어떻게 설명할지가 먼저 정해져야 한다. *peer connection 수, 방향성 있는 스트림, 관측해야 할 상태를 한 장에 겹쳐 본 메모다.
하나의 peer connection은 단순한 선 하나가 아니다. 생성 요청, 권한 확인, offer/answer 교환, ICE candidate 전달, 상태 변화, 재시도, 품질 통계, 종료 처리가 따라온다. 연결 수가 늘면 signaling 메시지도 늘고, 상태 전이도 늘고, 테스트해야 할 조합도 늘어난다. 실패 사례 역시 같은 속도로 늘지는 않더라도, 운영자가 구분해야 할 이름은 빠르게 많아진다. Mesh가 어떤 topology인지 다시 분류하려는 글이 아니다.
SFU와 비교해 우열을 가르려는 글도 아니다. 이미 Mesh를 고려하거나 작은 방에서 쓰고 있을 때, n(n-1)/2가 운영 비용으로 번역되는 과정을 차분히 따라가는 메모에 가깝다. 특히 Mesh에서는 재현 조건을 같이 적어야 의미가 있었다. n(n-1)/2를 다시 볼 때 남겨야 할 질문은 단순하다. 이 선은 누구의 업로드를 쓰는가. 이 상태 전이는 어디에 기록되는가. 실패했을 때 사용자는 어떤 선택지를 받는가. 여기까지 답할 수 있을 때 Mesh 연결 수는 데모용 공식이 아니라 제품 운영을 계산하는 도구가 된다.
'[Mesh 딥다이브 연결 수 공식으로 보는 Mesh의 비용'을 관통하는 질문은 이 섹션에서도 같았고, 답만 더 구체적이 됐다.
아직 열어 둔 비용
PonsLink에서 방과 peer 상태를 분리하려 했던 이유도 여기에 있다. 방은 하나지만 peer 간 연결은 여러 개이고, 각각 다른 실패를 가진다. PonsWarp에서는 파일 바이트가 반드시 서버 소유일 필요는 없지만, 직접 경로 실패와 backpressure와 중단 후 복구를 설명해야 했다. 두 제품 모두 Mesh 연결 수를 멋진 기술명으로 쓰기보다 경계 설계의 언어로 다뤄야 했다. 이 구분을 놓치면 회의실 계산이 쉽게 낙관적으로 흐른다.
5명 방의 peer connection은 10개지만, 각 참여자는 나머지 4명에게 데이터를 보내고 4명에게서 데이터를 받는다. 영상이라면 같은 카메라 프레임을 여러 번 인코딩하거나 전송해야 할 수 있고, 파일이라면 수신자의 속도 차이가 송신자의 backpressure로 돌아온다. 공식은 연결 쌍을 말하고, 제품 비용은 송수신 방향에서 다시 계산된다. realtime-network-08-me 이 실패 지도는 사용자를 위한 문장으로도 이어진다.
개발자는 candidate, bitrate, buffer, relay 같은 단어가 필요하다. 사용자는 지금 기다려도 되는지, 다른 경로로 전환 중인지, 상대 기기의 속도에 맞추는 중인지, 다시 초대해야 하는지 알고 싶다. 같은 상태를 두 언어로 번역하지 못하면 네트워크 문제는 늘 막연한 오류로 남는다. n(n-1)/2는 peer connection 쌍을 센다. 하지만 미디어나 파일 전송에서 실제 부담은 방향성 있는 스트림으로 다시 봐야 한다.
A와 B 사이의 peer connection은 하나로 세더라도, A가 B에게 보내는 업로드와 B가 A에게 보내는 업로드는 각 피어의 CPU, 네트워크, 버퍼에 따로 부담을 만든다. 질문도 이렇게 바뀐다. 연결 수가 몇 개인가에서 끝내지 않고, 이 연결이 실패하면 방 전체가 실패인가, 특정 상대만 실패인가를 묻는다. signaling 메시지가 늦어졌을 때 사용자는 재시도 버튼을 눌러야 하는가, 아니면 제품이 자동으로 우회해야 하는가를 묻는다.
계산식은 짧지만, 그 뒤에 붙는 운영 질문은 짧지 않다. 이 작은 차이가 비용 위치를 바꾼다. 이 표에서 중요한 값은 마지막 열이다. 연결 수가 얼마인지 아는 것만으로는 부족하다. 방 최대 인원, 품질 기본값, relay 전환 기준, 실패 문구, 로그 보존 범위를 같이 정해야 한다. 숫자를 쓰는 목적은 과장된 성능 주장을 만들기 위해서가 아니라, 어디까지 약속할 수 있고 어디부터 다른 경로가 필요한지 선을 긋기 위해서다.
마치며
참여자가 늘면 새 참여자 하나가 기존 참여자 모두와 약속을 맞춘다. 각 peer connection마다 offer/answer가 오가고 candidate가 여러 번 도착할 수 있다. 이 이벤트는 한 번에 끝나지 않는다. 브라우저 네트워크가 바뀌거나, 탭이 잠들었다가 깨어나거나, relay 경로로 바뀌면 상태가 다시 움직인다. 연결 수가 늘었다는 말은 이런 메시지와 상태 전이를 받을 표면도 늘었다는 뜻이다.
[과 [을 같이 보면 이 계산이 더 구체적으로 보인다. 하나는 WebRTC가 payload를 직접 소유하지 않는다는 감각을 다루고, 다른 하나는 DataChannel 전송에서 버퍼와 사용자의 기다림을 어떻게 볼지 다룬다. 초기 구현에서 이 부담이 잘 안 보이는 이유는 성공 경로가 너무 매끈하기 때문이다. 로컬 네트워크, 같은 브라우저, 빠른 노트북, 짧은 테스트 시간에서는 대부분의 연결이 조용히 성공한다.
그러면 연결 수가 늘어난다는 말도 단지 성능 여유를 조금 더 먹는 정도로 느껴진다. 실제 사용자는 회사망, 모바일 핫스팟, 오래 켜 둔 탭, 절전 모드, 느린 디스크 같은 조건을 들고 들어온다. 나는 이런 계산을 할 때 연결마다 작은 행을 만든다. A-B, A-C, A-D처럼 쌍을 적고, 그 옆에 signaling 완료 여부, selected candidate, 미디어 또는 파일 전송 상태, 마지막 재시도 시간을 붙인다. 그 다음에는 사용자 문장을 따로 둔다.
내부 로그가 failed라고 말해도 화면에는 상대와 직접 연결을 다시 시도하는 중처럼 행동 가능한 문장이 필요하다.