[P2P 파일 무결성] chunk hash와 Merkle tree는 왜 필요할까
파일 전송 화면에서 진행률이 96%까지 올라갔다. 사용자는 거의 끝났다고 느끼고, 개발자는 마지막 checksum만 맞으면 된다고 생각한다. 그런데 마지막 hash가 틀리면 제품은 갑자기 난처해진다. 어떤 조각이 깨졌는지 모르니 다시 받을 범위도 말하지 못한다. 그래서 용어 사전 대신, 그 날 무엇을 보고 무엇을 바꿨는지부터 적는다. 숫자로 포장하기보다, 재현 조건과 운영에서 고정한 규칙을 중심으로 적었다.
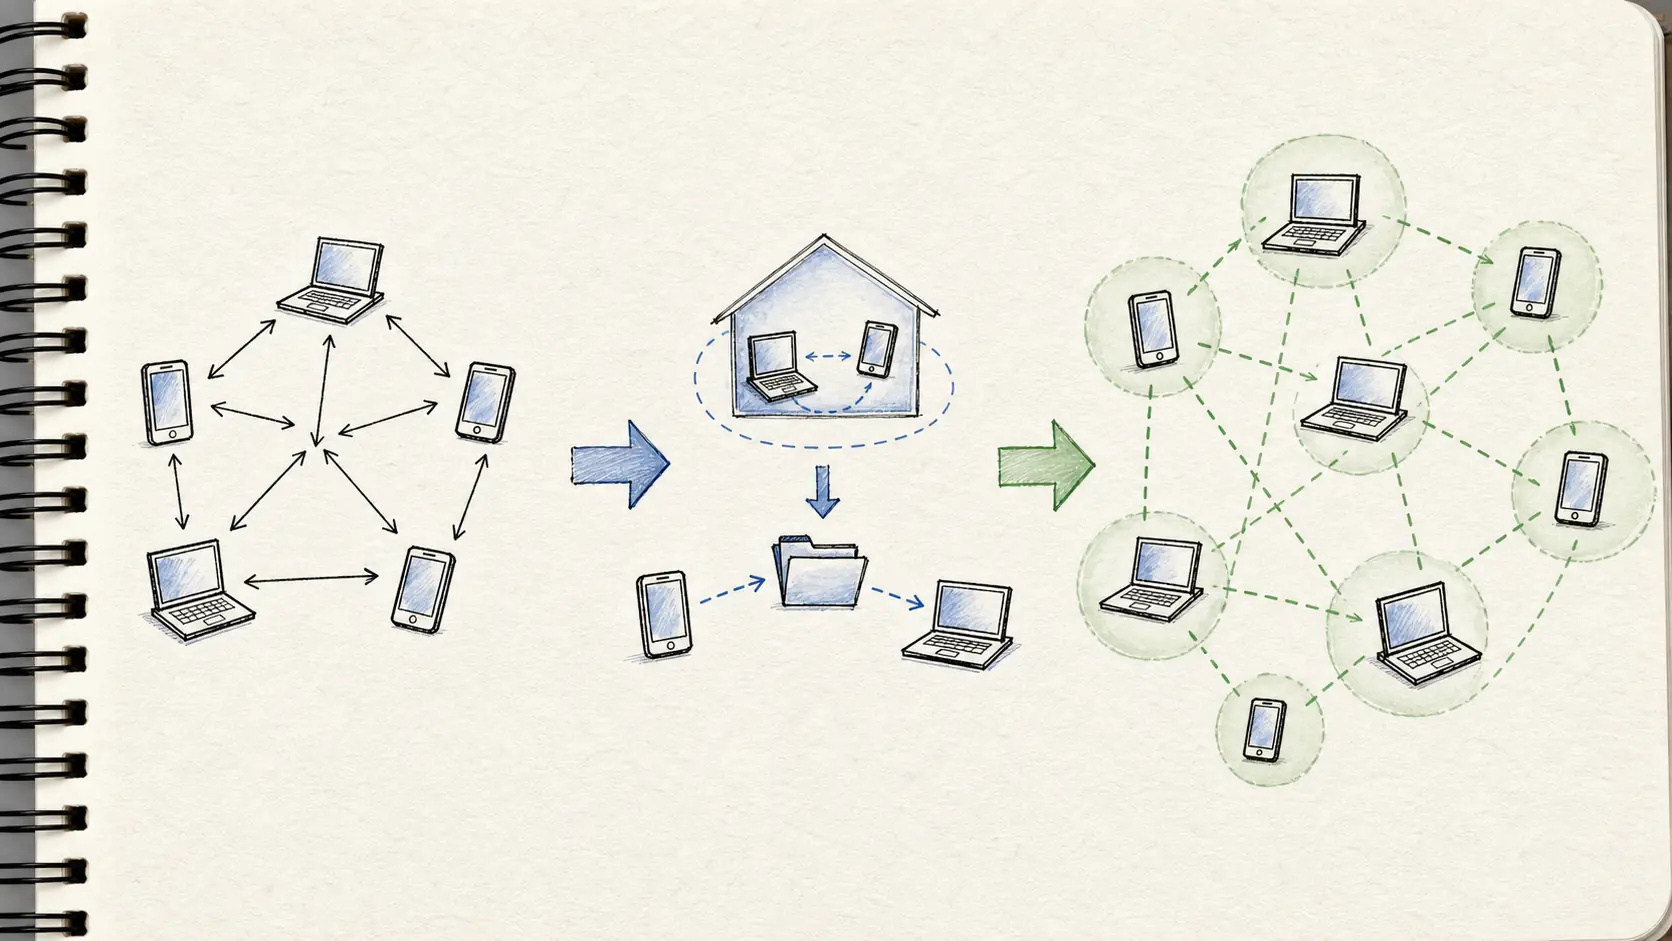
chunk 무결성이 커진 문제
로그 보존 기간도 작게나마 정해야 한다. hash 값 자체를 오래 남기는 것이 부담스럽다면, root version과 실패한 chunk index, retry 결과만 남길 수 있다. 사용자가 문의했을 때 필요한 것은 파일 내용이 아니라 어떤 상태에서 멈췄는지다. 개인정보와 운영 단서를 섞지 않으려면 로그 필드는 의도적으로 좁아야 한다. 작게 시작한다면 파일 본문은 피어끼리 보내고 manifest만 서버에 짧게 남기는 방식이 부담이 적다.
이때도 manifest에는 파일명보다 chunk count, root, 만료 시간처럼 복구에 필요한 최소값만 둔다. PonsWarp가 나중에 Cloud Drop 같은 모드를 붙이더라도, direct 전송과 임시 보관 전송의 manifest 정책은 분리되어야 한다. 같은 manifest라는 이름을 쓰더라도 payload 보관 여부가 다르면 사용자 약속도 달라진다. 전체 checksum만 두면 구현은 단순하다. 송신자가 파일 전체 hash를 알려 주고, 수신자는 파일을 다 받은 뒤 한 번 계산한다.
값이 맞으면 성공이고 다르면 실패다. 작은 파일이나 재전송 비용이 낮은 환경에서는 이 방식도 충분하다. 문제는 실패가 너무 늦게 보인다는 점이다. 이 이름은 개발자만 보라고 만든 장식이 아니다. support log, retry policy, 사용자 문구가 같은 상태를 가리켜야 한다. 사용자가 “다 받았는데 왜 다시 기다리나요?”라고 물었을 때, 운영자는 완료율이 아니라 검증 단계를 보고 답해야 한다.
처음에는 전체 해시로 충분할 줄 알았다
10GB 파일을 거의 다 받은 뒤 실패가 드러나면 사용자는 “거의 끝났다”는 감각을 이미 갖고 있다. 그때 제품이 처음부터 다시 받으라고 말하면 기술적으로 맞아도 경험은 거칠다. 어디가 깨졌는지 모르면 손상된 chunk 하나 때문에 멀쩡한 byte까지 다시 보내게 된다. P2P에서는 상대 피어가 계속 살아 있다는 보장도 약하므로, 늦은 실패는 곧 복구 실패가 될 수 있다.
- 파일을 고정 크기 chunk로 나누고 각 chunk hash를 기록한다. 2. 수신자는
stored와verified를 분리한다. 3. hash가 틀린 chunk만retry-chunk로 옮긴다. 4. resume 이후에는 저장된 chunk를 다시 검증한다. 5. Merkle root는 전체 manifest가 바뀌지 않았는지 확인하는 짧은 기준으로 둔다. UI에서도 같은 경계가 필요하다.stored-unverified상태에서 다운로드 완료 토스트를 띄우면 이후 실패가 배신처럼 느껴진다.retry-chunk상태에서 전체 진행률을 크게 낮추면 사용자는 거의 끝난 전송이 되돌아갔다고 오해한다.
그래서 표시값은 두 개가 낫다. 하나는 받은 byte 진행률이고, 다른 하나는 검증된 byte 진행률이다. 둘을 동시에 보여 주지 않더라도 내부에는 반드시 둘 다 남아야 한다. 동시에 송신자 화면도 필요하다. 수신자만 검증 상태를 알고 있으면 송신자는 왜 같은 chunk를 다시 요청받는지 이해하지 못한다. 송신자에게는 “손상된 조각 재전송 요청” 정도의 문구와 chunk index만 보이면 충분하다.
원본 파일을 다시 선택해야 하는지, 브라우저 탭을 유지해야 하는지, 상대가 이어받을 수 있는지 알려 주면 양쪽 경험이 맞아진다. P2P 전송은 한쪽 화면만 고쳐서는 신뢰가 생기지 않는다. 이때 송신자의 재전송 횟수와 수신자의 검증 실패 횟수를 함께 보면 악성 피어 의심과 단순 네트워크 손상을 조금 더 차갑게 나눌 수 있다. 같은 chunk가 여러 피어에서 반복해서 틀리면 manifest나 원본 기준을 의심하고, 특정 피어에서만 틀리면 해당 세션을 제한한다.
이런 판단은 사용자에게 길게 보일 필요는 없지만 운영자가 다음 배포에서 retry 제한을 조정할 근거가 된다. 작은 알림 하나보다 이 기록이 다음 장애를 줄인다. 재전송도 제품 경험이다. 파일이 클수록 이 정책은 더 중요해진다. 500MB 파일에서는 전체 재시도가 귀찮은 정도로 끝날 수 있지만, 10GB 파일에서는 사용자가 네트워크와 시간을 이미 크게 썼다.
이때 깨진 chunk 하나 때문에 모든 조각을 버리면 제품은 절약한 구현 시간을 사용자에게 전가한다. 반대로 검증 전 조각을 너무 오래 들고 있으면 저장소 압박과 개인정보 부담이 생긴다. 그래서 만료 시간, 최대 보관 용량, 재검증 우선순위를 같은 정책으로 묶어야 한다.
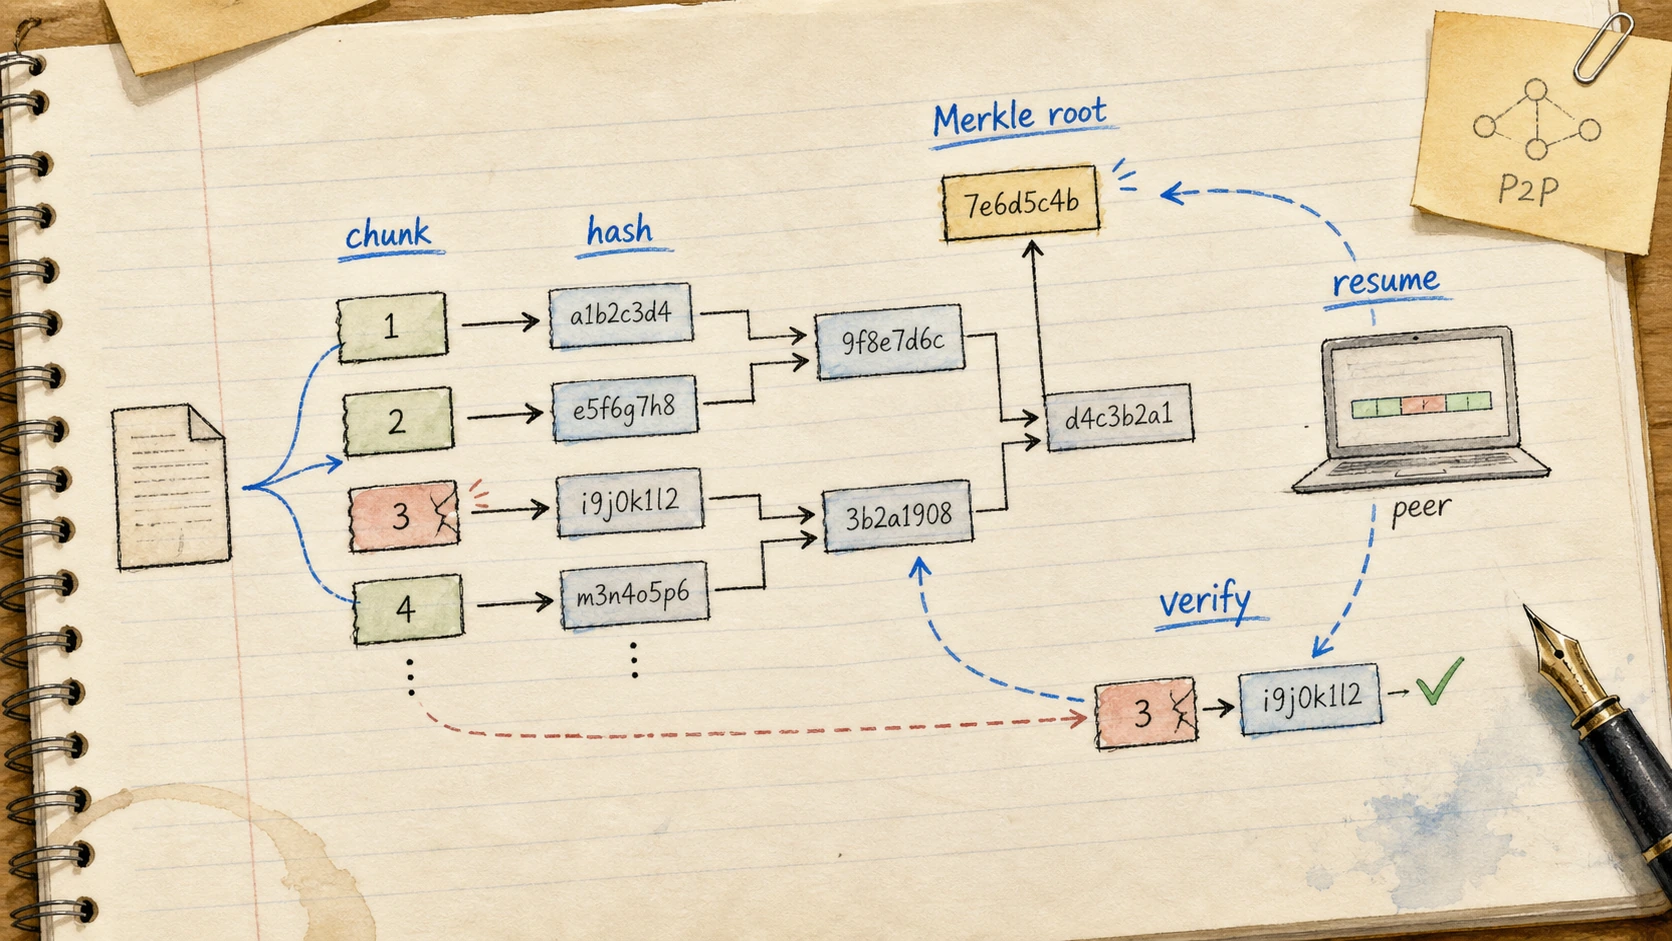
손상 지점이 선명해진 순간
측정값은 다섯 가지면 시작할 수 있다. chunk 검증 실패율, 재요청한 byte 수, Merkle root 불일치 수, resume 이후 재검증 시간, 완료 문구 지연 시간이다. 여기서 완료율만 보면 가장 중요한 불안을 놓친다. 거의 다 받은 파일이 정말 안전한지, 손상된 조각만 다시 받았는지, 사용자가 다시 눌러야 하는지 따로 봐야 한다. 결국 이 글에서 가져갈 기준은 하나다. P2P 파일 전송에서 믿어야 할 것은 진행률이 아니라 검증된 조각이다.
chunk hash와 Merkle tree는 더 순수한 P2P를 만들기 위한 장식이 아니라, 실패했을 때 다시 받을 범위를 말하기 위한 운영 언어다. 다음 구현에서는 완료 버튼보다 verified-file 상태를 먼저 설계해야 한다. 여기서 상태 이름을 나눠야 한다. stored는 저장됐다는 뜻이고, verified는 검증됐다는 뜻이다. 둘을 같은 완료 막대에 넣으면 화면은 편하지만 장애 분석은 흐려진다. 수신자는 저장 완료와 hash 검증 완료를 다른 상태로 기록해야 한다.
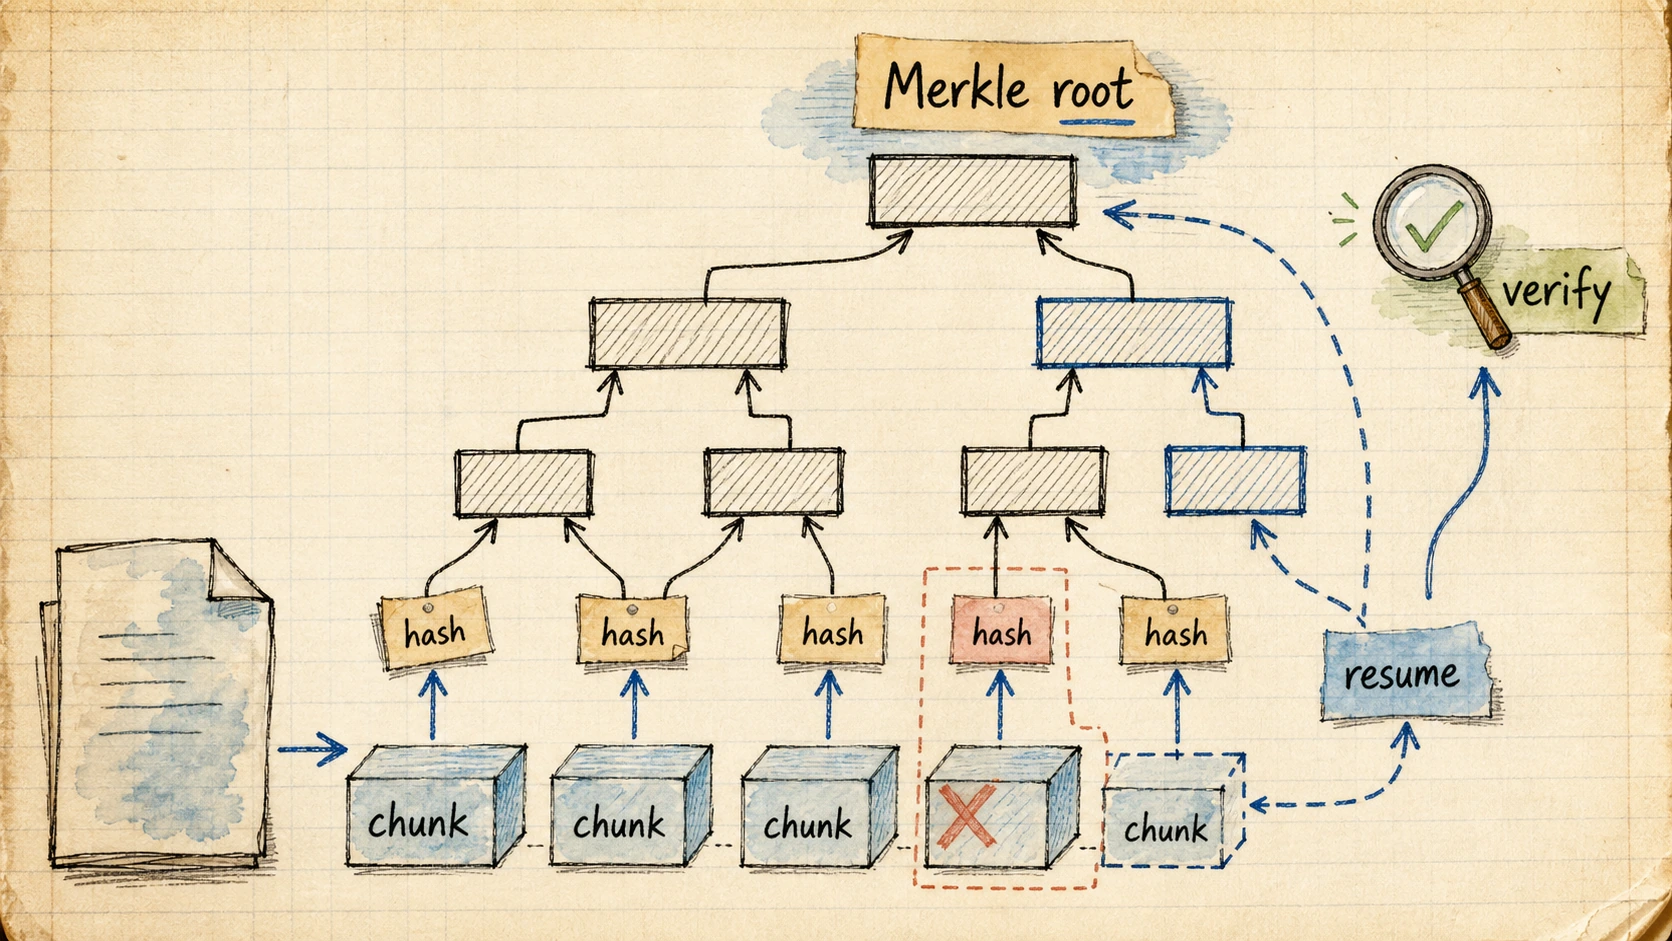
resume offset만 믿으면 이미 저장된 조각이 깨졌는지 모를 수 있기 때문이다. *Merkle tree와 chunk hash: 발견, 검증, 운영 경계를 한 장에 겹쳐 둔 흐름 노트. 보안 관점에서도 chunk hash는 편의 기능이 아니다. 악성 피어가 일부 조각만 바꾸는 경우 전체 hash는 마지막에만 잡아낸다. chunk 단위 검증은 조작 위치를 좁히고, 같은 조각을 다른 피어에게 다시 요청할 근거를 준다. Merkle tree는 그 많은 조각 hash가 같은 파일에서 나온 것인지 확인하는 짧은 기준이 된다.
이 구조를 넣으면 코드가 늘지만, 실패했을 때 설명 가능한 범위가 훨씬 작아진다. 이 순서는 P2P 순수성보다 복구 가능성을 먼저 본다. 서버가 manifest나 Merkle root를 잠깐 보관할 수도 있다. 중요한 것은 payload를 어디까지 맡겼는지와 검증 기준을 어디에 두었는지 사용자에게 거짓말하지 않는 일이다. P2P를 설명할 때 서버/클라이언트/사용자 중 누구 문장으로 말하는지 먼저 고르면 논쟁이 줄었다.
제품 밖으로 뺀 것
- 전체 checksum 실패가 났을 때 다시 받을 범위를 알고 있는가.
- chunk hash 목록과 파일 metadata를 어디에 보관할지 정했는가.
- 수신자는 저장 완료와 hash 검증 완료를 다른 상태로 기록하는가.
- resume offset만으로 완료를 말하지 않는가.
- Merkle root 불일치가 사용자에게 어떤 문장으로 보이는가.
- 악성 피어, 저장소 손상, 상대 이탈을 같은 로그로 뭉치지 않았는가. PonsLink와 PonsWarp의 전송 설계에서도 이 기준은 그대로 남는다. 사용자가 보는 완료 상태는 다운로드 종료가 아니라 검증이 끝난 상태여야 하고, 재시도는 전체 파일이 아니라 깨진 chunk부터 다시 시작해야 한다. | 기준 | 장점 | 늦게 드러나는 비용 | 제품 문구 | |---|---|---|---| | 전체 checksum | 구현이 단순하고 최종 판정이 명확하다 | 실패 위치를 모르면 큰 파일을 다시 받아야 한다 | “마지막 검증 중” | | chunk hash | 깨진 조각만 다시 요청할 수 있다 | index와 hash 목록 관리가 필요하다 | “손상된 조각만 다시 받는 중” | | Merkle root | 많은 chunk hash를 짧은 신뢰 기준으로 묶는다 | root와 proof를 다루는 코드가 추가된다 | “파일 기준값 확인 중” | | resume token | 중간 복구 흐름을 이어 준다 | token만으로는 저장 조각의 무결성을 보장하지 못한다 | “이어서 받기 준비 중” | 진행률만 믿고 완료 처리하면 마지막 검증에서 깨진 파일을 발견했을 때 사용자는 거의 다 된 전송이 통째로 사라졌다고 느낀다.
내부 계약이 바뀐 부분
또 하나의 경계는 삭제다. 사용자가 전송을 취소했을 때 stored-unverified 조각을 바로 지울지, resume 가능 시간을 두고 보관할지 정해야 한다. 보관하면 이어받기가 쉬워지고, 지우면 저장소와 개인정보 부담이 줄어든다. 이 선택은 hash 알고리즘보다 제품 정책에 가깝지만, 무결성 설계와 분리할 수 없다. Merkle tree와 chunk hash: 구현 전에 다시 볼 질문을 현장 노트처럼 정리한다. PonsWarp 같은 파일 전송 흐름에서는 이 차이가 화면 문구 진행률 100%가 곧 “안전한 파일”을 뜻하지 않으면, 완료 버튼을 늦게 보여 줘야 한다.
“저장은 끝났지만 검증이 남음”이라는 문구는 내부 용어를 노출하지 않으면서도 사용자가 왜 잠깐 더 기다리는지 알려 준다. 반대로 검증 상태를 숨기면 마지막 실패가 제품의 거짓말처럼 보인다. chunk hash는 파일을 빠르게 만드는 마법이 아니다. 핵심은 실패 범위를 좁히는 데 있다. 4MB 단위로 조각을 나눴다면, hash가 틀린 조각만 다시 요청할 수 있다.
더 작은 chunk를 쓰면 복구 범위는 더 줄지만 hash 목록, index, 저장소 정리, 검증 횟수가 늘어난다. 그래서 chunk 크기는 “작을수록 좋다”가 아니라 파일 크기, 네트워크 변동, 저장소 비용을 함께 본 정책이다. 대용량 P2P 파일 전송에서는 성공과 완료가 같은 말이 아니다. DataChannel을 통해 byte가 도착했고 OPFS나 브라우저 저장소에 일부가 남아 있어도, 그 조각이 원본과 같은지는 별도의 검증으로 확인해야 한다.
전체 checksum은 최종 판정에는 좋지만 중간 복구에는 느리다. chunk hash는 재전송 범위를 작은 조각으로 줄이고, Merkle root는 많은 조각 검증 정보를 짧게 대표한다. '[P2P 파일 무결성 chunk hash와 Merkle tree는 왜 필요할까'을 관통하는 질문은 이 섹션에서도 같았고, 답만 더 구체적이 됐다.
아직 열어 둔 비용
| 로그 필드 | 왜 필요한가 | 사용자에게 보일 말 | |---|---|---| | chunk index | 어느 조각이 깨졌는지 찾는다 | “일부 조각 확인 중” | | expected hash / actual hash | 송신 기준과 수신 결과를 비교한다 | 직접 노출하지 않음 | | retry byte count | 전체 재전송을 피했는지 본다 | “손상된 부분만 다시 받는 중” | | peer id 또는 session id | 같은 피어에서 반복되는 실패를 본다 | 직접 노출하지 않음 | | resume 이후 재검증 시간 | 이어받기가 실제로 안전했는지 확인한다 | “이어서 받은 파일 확인 중” |
무결성 실험은 정상 파일만 보내서는 부족하다. 일부러 하나의 chunk를 바꾸고, 이미 저장됐지만 검증 안 된 chunk를 만들고, resume 뒤에 같은 조각을 다시 검증해야 한다. 사용자는 진행률이 높을수록 남은 시간이 짧다고 믿는다. 검증 실패가 그 기대를 깨뜨릴 때 제품은 이유와 다음 행동을 같이 보여 줘야 한다. hash 불일치가 보이면 원인을 하나로 몰아가기 쉽다.
하지만 악성 피어가 다른 byte를 보냈을 수도 있고, 네트워크 중간에서 문제가 생겼을 수도 있고, 저장소에 기록하는 과정에서 깨졌을 수도 있다. P2P 전송에서는 이 구분이 중요하다. 같은 실패 화면이라도 다음 행동이 달라진다. 처음부터 완전한 Merkle proof 교환과 다중 피어 검증을 넣으려 하면 구현 표면이 넓어진다. 작은 제품에서는 먼저 깨진 chunk를 발견하고, 해당 chunk만 다시 요청하고, 완료 문구를 검증 뒤로 미루는 흐름부터 잡는 편이 낫다.
이 정도만 해도 전체 checksum 하나보다 운영 단서가 훨씬 늘어난다. 내가 chunk hash와 Merkle tree를 다시 본 이유는 속도 경쟁이 아니었다. 질문은 더 작았다. 완료율이 96%일 때 제품은 무엇을 믿어야 할까? 전체 파일을 한 번에 믿을지, 저장된 조각을 하나씩 검증할지, 검증 전 저장소를 사용자에게 어떻게 설명할지 정해야 했다. 이 표가 채워질 때 Merkle tree와 chunk hash는 공부한 개념에서 제품 기능으로 내려온다.
표를 채우지 못하면 root, proof, hash라는 단어는 많아도 사용자가 만나는 실패를 설명하지 못한다.
마치며
악성 피어가 의심되면 같은 chunk를 다른 피어에게 다시 요청해야 한다. 로컬 저장소 손상이 의심되면 이미 받은 조각을 지우고 다시 검증해야 한다. 상대 피어가 떠났다면 resume token으로 이어받을 수 있는지 봐야 한다. 이 세 경우를 모두 “파일 전송 실패”로 합치면 재시도 버튼은 생기지만 원인은 사라진다. - pending-chunk: 조각을 아직 받는 중이다. - stored-unverified: byte는 저장됐지만 hash 검증 전이다.
verified-chunk: chunk hash가 맞다. -root-mismatch: Merkle root 기준으로 전체 조합이 맞지 않는다. -retry-chunk: 깨진 조각만 다시 요청한다. -verified-file: 사용자에게 완료를 말할 수 있다. 로그 보존 기간도 작게나마 정해야 한다. hash 값 자체를 오래 남기는 것이 부담스럽다면, root version과 실패한 chunk index, retry 결과만 남길 수 있다. 사용자가 문의했을 때 필요한 것은 파일 내용이 아니라 어떤 상태에서 멈췄는지다. 개인정보와 운영 단서를 섞지 않으려면 로그 필드는 의도적으로 좁아야 한다.
작게 시작한다면 파일 본문은 피어끼리 보내고 manifest만 서버에 짧게 남기는 방식이 부담이 적다. 이때도 manifest에는 파일명보다 chunk count, root, 만료 시간처럼 복구에 필요한 최소값만 둔다. PonsWarp가 나중에 Cloud Drop 같은 모드를 붙이더라도, direct 전송과 임시 보관 전송의 manifest 정책은 분리되어야 한다. 같은 manifest라는 이름을 쓰더라도 payload 보관 여부가 다르면 사용자 약속도 달라진다.